خودشناسی دادهمحور و تفاوت آن با خودبرچسبزنی
خودشناسی دادهمحور چگونه به شناخت الگوهای رفتاری، هیجانی و فردی کمک میکند؟ در این مقاله، تفاوت خودشناسی دادهمحور با خودبرچسبزنی، نقش هوش مصنوعی و یادگیری ماشین و محدودیتهای استفاده از دادههای شخصی در توسعه فردی را بررسی میکنیم.
خودشناسی دادهمحور
بسیاری از ما درباره خودمان تصوری کلی داریم: میدانیم چه چیزهایی ناراحتمان میکند، در چه موقعیتهایی عملکرد بهتری داریم یا معمولاً چگونه با فشار روانی کنار میآییم. اما آیا این برداشتها همیشه دقیقاند؟ آیا میتوانیم بهدرستی تشخیص دهیم چه موقعیتهایی بیشترین تأثیر را بر خلقوخو، تمرکز، انگیزه یا رفتار ما دارند؟
خودشناسی دادهمحور (Data-Driven Self-Knowledge) رویکردی است که در آن، بهجای اتکا به برداشتهای کلی و خاطرات پراکنده، از دادههای مرتبط با زندگی روزمره برای شناسایی الگوهای شخصی استفاده میکنیم.
این دادهها میتوانند شامل ثبت روزانه خلقوخو، کیفیت خواب، سطح انرژی، عادتها، فعالیتها، تمرکز یا واکنشهای فرد در موقعیتهای مختلف باشند. تحلیل این اطلاعات ممکن است به شناسایی ارتباطها و الگوهایی کمک کند که از طریق مشاهده معمولی بهسادگی قابل تشخیص نیستند.
هدف، تبدیل دادهها به شناختی کاربردیتر از خود است؛ نه اینکه هر تجربه انسانی را به یک عدد تقلیل دهیم یا برای هر تغییر رفتاری، یک برچسب روانشناختی بسازیم.
چرا شناخت خودمان همیشه آسان نیست؟
شناخت انسان از خودش تحت تأثیر عوامل متعددی قرار دارد. حافظه ما همه رویدادها را با دقت یکسان نگه نمیدارد، تجربههای برجسته ممکن است بیش از اتفاقات روزمره در قضاوتهای ما نقش داشته باشند و وضعیت هیجانی فعلی نیز بر نحوه تفسیر گذشته اثر بگذارد.
برای مثال، ممکن است فردی تصور کند که همیشه در روزهای کاری اضطراب بیشتری دارد؛ اما ثبت منظم اطلاعات نشان دهد که اضطراب او بیشتر با کمبود خواب، حجم کار یا نوع خاصی از تعاملات اجتماعی ارتباط دارد، نه صرفاً با روزهای کاری.
این مثال به معنای اثبات رابطه علّی نیست. ثبت دادهها میتواند به شناسایی الگوهای احتمالی کمک کند، اما برای فهمیدن علت یک تجربه، به بررسی دقیقتر و گاهی ارزیابی تخصصی نیاز داریم.
سه محدودیت رایج در خودشناسی معمول عبارتاند از:
اتکا به حافظه: ممکن است تجربههای شدید یا تازه را بیش از سایر تجربهها به یاد بیاوریم.
تعمیم بیش از حد: چند تجربه محدود را به الگویی همیشگی در زندگی خود تبدیل کنیم.
نادیده گرفتن زمینه: رفتار یا هیجان را بدون توجه به خواب، محیط، روابط و شرایط روزمره تفسیر کنیم.
دادههای منظم میتوانند به بررسی این برداشتها کمک کنند؛ البته به شرط آنکه کیفیت دادهها، زمینه ثبت و محدودیتهای تحلیل نیز در نظر گرفته شوند.
خودشناسی دادهمحور چگونه کار میکند؟
یک فرایند ساده خودشناسی دادهمحور را میتوان در چهار مرحله توضیح داد.
۱. ثبت اطلاعات مرتبط با زندگی روزمره
در مرحله نخست، فرد اطلاعاتی را ثبت میکند که با هدف شناخت او مرتبطاند. برای مثال، اگر هدف شناخت بهتر الگوهای تمرکز باشد، ثبت مدت تمرکز، کیفیت خواب، وقفههای کاری و سطح انرژی میتواند مفید باشد.
لازم نیست همه جنبههای زندگی بهصورت مداوم ثبت شوند. انتخاب دادههای مناسب و قابلاستفاده، معمولاً از جمعآوری حجم زیادی از اطلاعات نامرتبط ارزشمندتر است.
۲. شناسایی الگوها
پس از جمعآوری اطلاعات کافی، میتوان بررسی کرد که چه تغییراتی در طول زمان تکرار میشوند. آیا سطح انرژی در ساعات مشخصی کاهش پیدا میکند؟ آیا تمرکز در بعضی شرایط بهتر است؟ آیا تغییرات خواب با تغییرات خلقوخو همراهاند؟
در این مرحله، نمودارها، خلاصههای آماری و روشهای تحلیل داده میتوانند به مشاهده الگوهایی کمک کنند که در نگاه روزمره کمتر دیده میشوند.
۳. تفسیر الگوها در بستر زندگی فرد
یک الگوی آماری بهتنهایی توضیح کاملی از تجربه فرد ارائه نمیدهد. اهمیت آن به زمینه، کیفیت اطلاعات و تفسیر فرد بستگی دارد.
برای مثال، مشاهده همزمانی کاهش خواب و افت خلقوخو بهتنهایی مشخص نمیکند که کمبود خواب باعث افت خلق شده است، افت خلق خواب را مختل کرده یا عامل دیگری بر هر دو اثر گذاشته است.
بنابراین، دادهها بهتر است نقطه شروعی برای پرسشهای دقیقتر باشند، نه نتیجهگیریهای قطعی درباره خودمان.
۴. تبدیل شناخت به تغییرات عملی
در نهایت، خودشناسی زمانی کاربردیتر میشود که به تصمیم یا اقدام مشخصی منجر شود. فرد ممکن است بر اساس الگوهای مشاهدهشده، زمان استراحت خود را تغییر دهد، عادتهای خوابش را بررسی کند یا شرایط مناسبتری برای تمرکز ایجاد کند.
پس از اجرای این تغییرات نیز میتوان بررسی کرد که آیا الگوی موردنظر تغییر کرده است یا خیر. این چرخه، خودشناسی را از مجموعهای از اطلاعات پراکنده به فرایندی برای یادگیری و توسعه فردی تبدیل میکند.
نقش هوش مصنوعی و یادگیری ماشین در خودشناسی
با افزایش حجم دادههای شخصی، بررسی همه اطلاعات بهصورت دستی میتواند دشوار شود. هوش مصنوعی و یادگیری ماشین میتوانند در خلاصهسازی دادهها، شناسایی الگوهای تکرارشونده، بررسی تغییرات در طول زمان و ارائه بازخوردهای متناسب با اطلاعات فرد نقش داشته باشند.
برای نمونه، یک سامانه دادهمحور ممکن است به فرد کمک کند تا متوجه شود در چه شرایطی معمولاً تمرکز بیشتری دارد یا چه تغییراتی در عادتهای روزانه با تغییر سطح انرژی او همراهاند.
با این حال، چند نکته مهم باید در نظر گرفته شود:
پیشبینی به معنای توضیح نیست. یک مدل ممکن است الگویی را شناسایی کند، بدون آنکه علت آن را بداند.
الگوهای گذشته تضمینکننده آینده نیستند. شرایط زندگی و رفتار انسان در طول زمان تغییر میکنند.
دقت مدل به کیفیت دادهها وابسته است. ثبتهای ناقص، سوگیریهای اندازهگیری یا تغییر در عادتهای فرد میتوانند نتیجه تحلیل را تحت تأثیر قرار دهند.
خروجی الگوریتم باید قابلتفسیر و متناسب با هدف باشد. هر الگوی آماری لزوماً اهمیت عملی یا روانشناختی ندارد.
بنابراین، ارزش هوش مصنوعی در خودشناسی صرفاً به تولید پیشبینی محدود نمیشود؛ بلکه به این بستگی دارد که آیا میتواند اطلاعات را به بینشی قابلفهم، محتاطانه و مفید برای فرد تبدیل کند یا خیر.
تفاوت خودشناسی دادهمحور با خودبرچسبزنی چیست؟
یکی از مهمترین تمایزها در استفاده از فناوریهای سلامت روان، تفاوت میان شناخت الگوهای شخصی و تشخیص یک اختلال روانشناختی است.
خودشناسی دادهمحور به پرسشهایی مانند این میپردازد: «چه موقعیتهایی معمولاً با کاهش انرژی من همراهاند؟»، «چه عادتهایی به تمرکز من کمک میکنند؟» یا «در طول چند هفته گذشته، الگوی خواب من چگونه تغییر کرده است؟»
در مقابل، خودبرچسبزنی زمانی مطرح میشود که فرد بر اساس نشانهها، پرسشنامههای آنلاین یا خروجی یک سامانه، نتیجه بگیرد که به اختلال روانشناختی مشخصی مبتلاست.
این دو یکسان نیستند. وجود یک الگوی رفتاری یا هیجانی بهتنهایی برای تشخیص اختلال کافی نیست. تشخیص بالینی به ارزیابی تخصصی، بررسی مجموعه نشانهها، مدت و شدت آنها، میزان اختلال در عملکرد و عوامل زمینهای نیاز دارد.
خودشناسی دادهمحور جایگزین ارزیابی روانشناختی نیست. در صورت تداوم ناراحتی روانی، افت عملکرد یا نگرانی درباره علائم، مراجعه به متخصص میتواند به درک دقیقتر وضعیت و انتخاب مسیر مناسب کمک کند.
خودشناسی دادهمحور چه ارتباطی با سلامت روان دیجیتال دارد؟
فناوریهای سلامت روان دیجیتال امکان ثبت و بررسی تجربههای روزمره را در محیط واقعی زندگی فراهم میکنند. در این میان، روشهایی مانند ارزیابی لحظهای بومنگر (Ecological Momentary Assessment — EMA) به جمعآوری اطلاعات نزدیک به زمان وقوع تجربهها کمک میکنند.
در مقایسه با پرسشنامههایی که به یادآوری یک دوره طولانی وابستهاند، ثبتهای مکرر ممکن است تصویر دقیقتری از تغییرات روزمره ارائه دهند. البته این مزیت به طراحی مناسب ارزیابی، مشارکت فرد و کیفیت پاسخها وابسته است.
در کنار EMA، روشهای تحلیل طولی و یادگیری ماشین میتوانند به بررسی روندها و تفاوتهای فردی کمک کنند. هدف، تولید شناختی متناسبتر با شرایط واقعی هر فرد است؛ نه فرض اینکه همه افراد با یک الگو یا راهکار یکسان بهتر عمل میکنند.
محصول افق در اکوسیستم سایکوتک چه جایگاهی دارد؟
در اکوسیستم دیجیتال سایکوتک، محصول افق با ایده خویشتن کمیسازیشده (Quantified Self) و استفاده از یادگیری ماشین برای شناخت بهتر الگوهای شخصی طراحی شده است. رویکرد آن، استفاده از دادههای فردی برای پشتیبانی از خودشناسی و توسعه فردی است.
در چنین رویکردی، دادهها میتوانند زمینهای برای بررسی عادتها، شناخت روندها و انتخاب ماژولهای مرتبط با رشد فردی فراهم کنند. ارزش این فرایند به آن است که تحلیل داده در خدمت پرسشهای معنادار و تصمیمهای کاربردی قرار بگیرد.
این جایگاه با محصولات دیگر سایکوتک نیز تفاوت دارد. برای مثال، التیام بر ارزیابی لحظهای بومنگر و مداخلات لحظهای تمرکز دارد و در بخش EMA خود قابلیت تحلیل مبتنی بر AutoML را ارائه میکند. افق، در مقابل، بر خودشناسی دادهمحور و توسعه فردی برای مخاطبان عمومی متمرکز است.
این محصولات بخشهایی از یک اکوسیستم گستردهتر هستند که در آن، فناوری و علم داده با نیازهای متفاوت در روانشناسی و توسعه فردی پیوند میخورند.
ملاحظات اخلاقی و محدودیتهای خودشناسی دادهمحور
هرچه شناخت ما از خود بیشتر به دادههای شخصی وابسته شود، توجه به نحوه جمعآوری، نگهداری و استفاده از این اطلاعات اهمیت بیشتری پیدا میکند.
دادههای مربوط به خلقوخو، خواب، عادتها و روابط ممکن است اطلاعات حساسی درباره زندگی فرد آشکار کنند. بنابراین، شفافیت درباره استفاده از دادهها، حفاظت از حریم خصوصی و امکان کنترل اطلاعات شخصی ضروری است.
از سوی دیگر، پایش مداوم خود همیشه مفید نیست. اگر ثبت و تحلیل اطلاعات به نگرانی افراطی درباره نوسانات طبیعی زندگی، قضاوت سختگیرانه درباره خود یا وابستگی بیش از حد به اعداد منجر شود، ممکن است هدف اولیه خودشناسی تضعیف شود.
خودشناسی دادهمحور زمانی ارزشمند است که به درک بهتر تجربهها کمک کند، نه اینکه فرد را به نظارت دائمی بر خود یا تلاش برای بهینهسازی تمام لحظات زندگی سوق دهد.
جمعبندی: دادهها برای شناخت بهتر ما هستند، نه تعریف کامل ما
خودشناسی دادهمحور، رویکردی برای بررسی منظم تجربههای شخصی و شناسایی الگوهای رفتاری و هیجانی است. این رویکرد با کمک روشهای آماری، یادگیری ماشین و ابزارهای دیجیتال میتواند به شناخت دقیقتر عادتها و تصمیمگیری آگاهانهتر کمک کند.
با این حال، دادهها تمام پیچیدگی تجربه انسانی را پوشش نمیدهند. یک الگوی آماری لزوماً علت یک تجربه را مشخص نمیکند و شناسایی یک نشانه نیز به معنای تشخیص اختلال نیست.
در نهایت، فناوری زمانی به خودشناسی کمک میکند که دادهها را در کنار زمینه زندگی، تجربه شخصی و قضاوت سنجیده قرار دهد. هدف، ساختن تصویری کامل و قطعی از انسان نیست؛ بلکه فراهم کردن فرصتهایی بهتر برای مشاهده، یادگیری و انتخاب آگاهانهتر است.
مطالب مرتبط
خویشتن کمیسازیشده (Quantified Self) چیست؟ از ثبت دادههای روزمره تا توسعه فردی
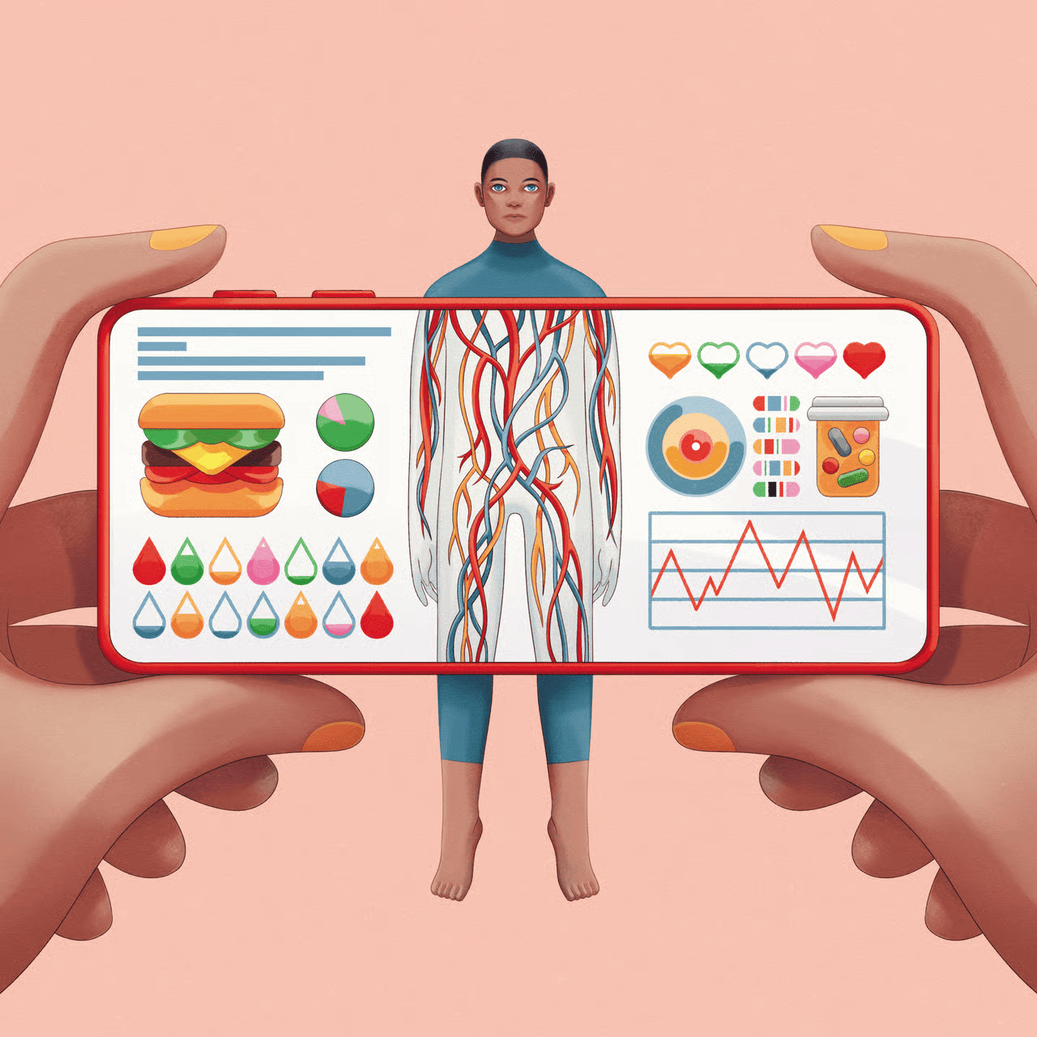
خویشتن کمیسازیشده رویکردی برای شناخت بهتر الگوهای زندگی از طریق ثبت و تحلیل دادههای شخصی است. در این مقاله با مفهوم Quantified Self، کاربردهای آن در سلامت روان و توسعه فردی، نقش هوش مصنوعی و محدودیتهای پایش دادههای شخصی آشنا میشویم.
ادامه مطلب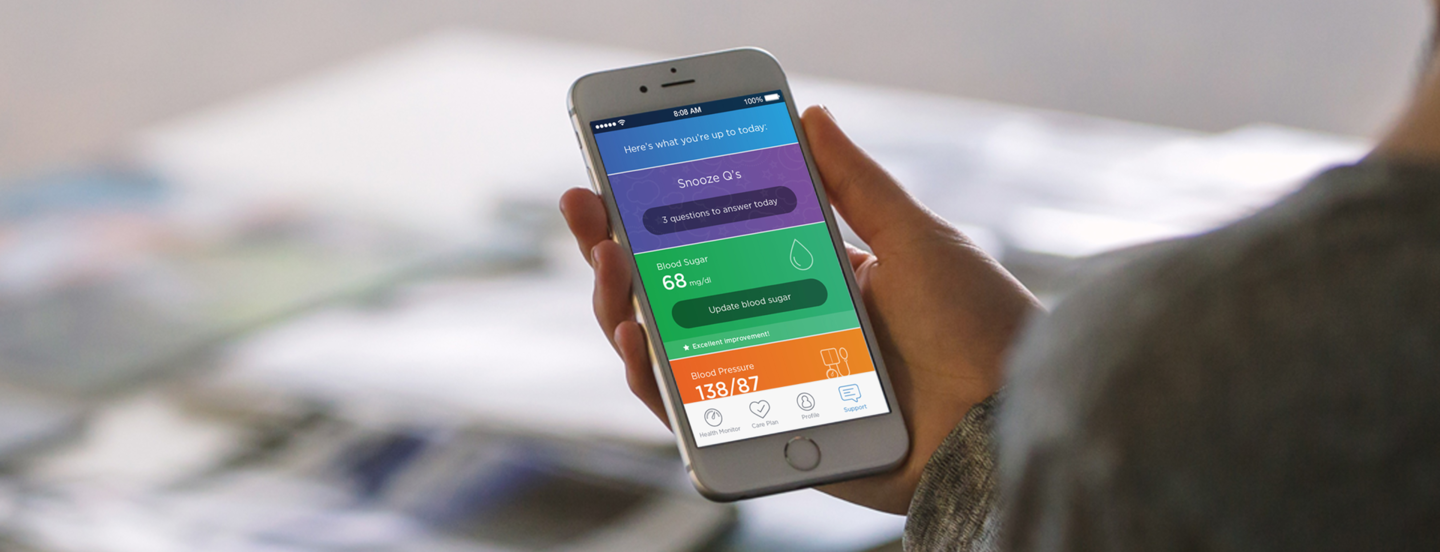
چرا یک نسخه برای همه جواب نمیدهد؟ از تفاوتهای فردی تا سلامت روان شخصیسازیشده
افراد در تجربه هیجانها، واکنش به استرس و الگوهای رفتاری با یکدیگر تفاوت دارند. این مقاله بررسی میکند که دادههای فردی، سنجشهای مکرر و یادگیری ماشین چگونه میتوانند به شخصیسازی ابزارهای سلامت روان دیجیتال کمک کنند و این رویکرد با چه محدودیتها و ملاحظات اخلاقی همراه است.
ادامه مطلب
سلامت روان دیجیتال چیست؟ آشنایی با نقش فناوری در آینده سلامت روان
سلامت روان دیجیتال به استفاده از فناوریهای دیجیتال برای پیشگیری، ارزیابی، پایش، پژوهش و ارائه خدمات مرتبط با سلامت روان اشاره دارد. در این مقاله با مفهوم سلامت روان دیجیتال، فرصتها و چالشهای آن و نقش هوش مصنوعی، داده و ابزارهای دیجیتال در آینده روانشناسی آشنا میشوید.
ادامه مطلب